概念 · 多模型挖矿
一条链,多个模型:TensorCash 如何同时运行多种 AI 模型
没有管理员开关,没有模型委员会,也不要求每个模型赢得同样多的区块。
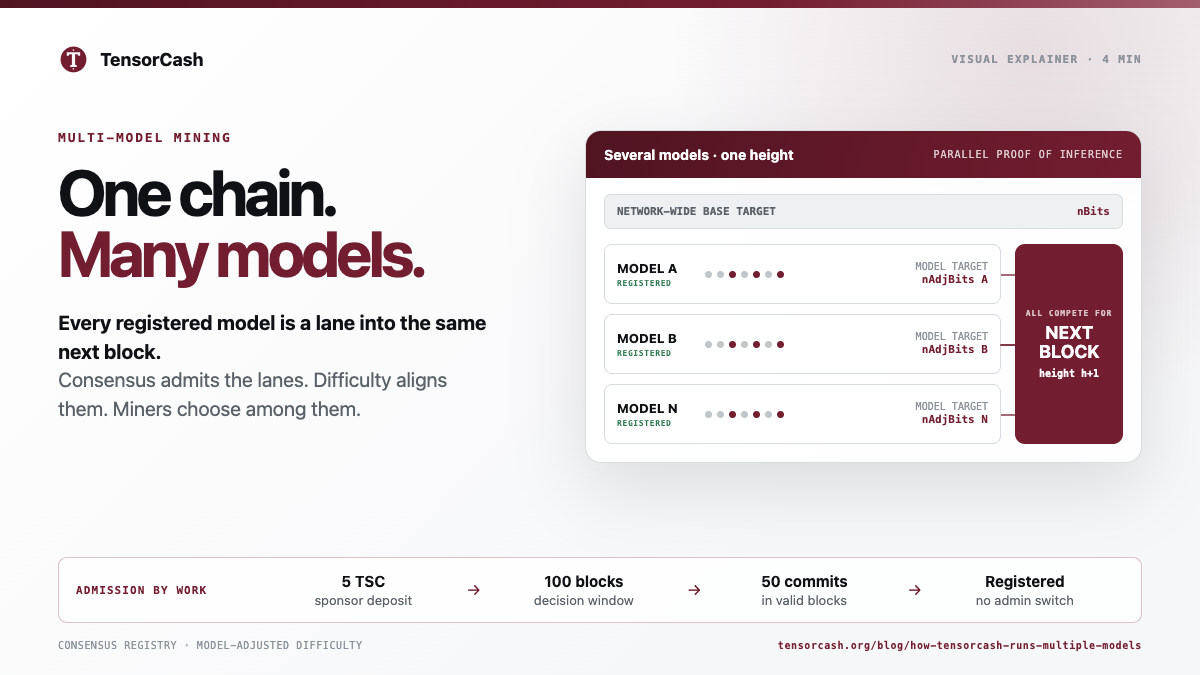
很多人以为,采用真正派得上用场的工作量证明的链,只能选定一个 AI 模型,然后永远用下去。TensorCash 不是这样。
简单说:每个已注册模型都是通往同一个下一区块的一条有效赛道。网络通过共识决定有哪些赛道,为每条赛道设置按模型调整后的目标值,再由矿工选择哪条值得跑。
下面稍微展开一点。
模型靠共识加入,不靠管理员开关
新模型通过链上注册提出:
- 发起人提交一笔 5 TSC 注册保证金,并承诺模型的公开身份、版本、内容引用和建议难度系数。
- 随即进入一个 100 个区块的确认窗口。
- 这 100 个区块中,至少要有 50 个区块包含支持该模型的 commit 交易,每笔交易都回指这次注册。
- 达到门槛并通过注册检查后,模型就能用于挖矿;否则不能。
这就是算力投票。只有 commit 被写进有效区块才算支持,而这些区块必须由网络此前已经接纳的模型产出。这里没有一个带着「启用模型」按钮的运营后台,也不是按矿工身份一人一票。真正稀缺的是产出区块的工作量。
这个过程也可以反向运行。如果某个已注册模型后来被发现存在退化或不诚实的问题,挑战会开启相应的 100 区块窗口。50 笔挑战 commit 可以把它移入封禁状态。因此,无论接纳还是移除模型,靠的都是链本身的工作量,而不是一位常任管理员。
一个高度,多条难度赛道
TensorCash 区块头包含两个彼此关联的难度字段:
nBits是全网统一的基础目标值。它让出块速度保持在计划范围内,也为链工作量和分叉选择提供统一计量单位。nAdjBits是当前区块实际要解出的目标值,会根据产出这份推理证明的已注册模型进行调整。
连接两者的是模型注册时确定的难度系数。简化后的关系是:
adjusted target ≤ base target × normaliser ÷ model difficulty
假设一个模型每生成一个 token 所需的工作量大约是另一个模型的两倍。提案可以把它的初始难度系数设为约一半,让目标空间扩大约一倍。这样,合格证明出现的速度也会快约一倍,用来补偿额外的推理工作。这个数值随注册一起由网络确认,服务器运营方不能在后台悄悄修改。
正因如此,模型 A、模型 B 和模型 C 可以在同一时间挖同一个高度。它们不是几条独立的链,也不需要轮班。每个模型都通过自己的调整后赛道生成有效候选区块;第一个有效区块传播出去,之后照常按工作量证明规则处理分叉。
起跑线公平,不等于市场份额相同
按模型调整难度,是为了让不同模型站上大致可比的起跑线。它并不替矿工决定 GPU 应该跑什么。
矿工要同时考虑三笔账:
- 区块补贴收入;
- 出售推理所得的收入;以及
- 模型、硬件和服务配置的成本。
任何一个时点,都可能有一种模型与硬件组合占据绝对优势。这不是多模型支持失效,而是市场在告诉大家:哪种推理最值得生产。市场对大模型的需求足够高时,可以覆盖它更高的成本;如果延迟或吞吐更重要,更便宜的模型可能胜出。
矿工还可以自行选择批处理和上下文配置。这些选择会改变吞吐、延迟、显存占用,以及所售推理的价值。最合理的运行方式,同样由经济账决定,而不是由协议委员会决定。
这并不需要再造一类验证者
还有一种常见误解:TensorCash 必须另外招募一批验证者来给模型打分。并不需要。
推理证明的验证使用协议规定的统计检验,但共识结果是客观的:所有节点都按同一套规则检查证明和已注册模型。没有人投票决定一个答案「看起来够不够聪明」,也没有按质押量加权的委员会给答案质量排名。
当然,运行上仍有成本。要完全自行验证,矿工或矿池需要能够访问验证潜在区块所需的已接纳模型。验证也可以委托出去,让这部分负担留在矿池或验证服务层,而不是压到每一个 GPU worker 上。委托只改变计算在哪里执行,不会改变共识规则。
看一遍完整闭环
Bob Labs 的 TensorCash 聊天服务把整个闭环放在了同一个页面上。目前它提供 Qwen3-8B:每条回复都由矿工的 GPU 实时生成,回复背后的那次推理同时也是推理证明挖矿工作。同一服务也通过 API 开放,因此智能体框架和其他客户端可以直接接入这份算力,不必再造一层共识。
以后有更多常规的因果自回归模型完成注册并上线服务,链本身不需要重新设计。模型注册表、并行难度赛道和验证规则都已经存在。
一条链,N 个模型。网络负责接纳,难度负责归一,市场决定运行哪个。